Бесплатная версия поможет не только получить точную расшифровку, но и быстро выделить главное:
- Расшифровать аудио или видео продолжительностью до 45 минут — более длинную запись можно загрузить по частям.
- Получить автоматический протокол встречи с основными итогами, договорённостями и поручениями.
- Задать до пяти вопросов AI-ассистенту и найти нужную информацию в расшифровке.
Попробуйте сервис бесплатно и получите первую расшифровку уже сейчас.
Транскрибация аудио в текст бесплатно — на той же модели, что у корпораций
Без лимита минут в месяц, с разделением по спикерам и пунктуацией. Данные хранятся в России.
Час встречи — это потом ещё два-три часа над протоколом: переслушать запись, переписать, вспомнить, кто что обещал. Я сам годами так работал: сначала диктофон, потом ручные протоколы, ошибки и споры «я такого не говорил».
Таймлист делает транскрибацию аудио в текст бесплатно и без урезанной модели: частные пользователи получают ту же нейросеть, что работает у наших корпоративных клиентов. Всё онлайн — загружаете запись, получаете текст. Ниже — что входит в бесплатную версию, как нейросеть переводит речь в текст, зачем лимит 45 минут на файл и как мы защищаем записи.
Что входит в бесплатную транскрибацию и где обычно подвох
Слово «бесплатно» у нас в IT вызывает нервный тик. Обычно за ним прячется облегчённая модель, лимит в 10 минут или запрет на копирование текста.
У Таймлиста нет «полной» и «урезанной» модели. Мы внедряем ИИ в закрытый контур крупных российских компаний, и бесплатная расшифровка аудио работает на той же архитектуре: те же веса, те же алгоритмы, та же точность — 96–97% на чистой записи по нашим внутренним замерам. Модель дообучена на русской деловой речи, а не просто скачана с западных датасетов.
Вот чем это отличается от типичного бесплатного тарифа. Бренды называть не буду — если вы хоть раз гуглили «транскрибация», вы их и так знаете.
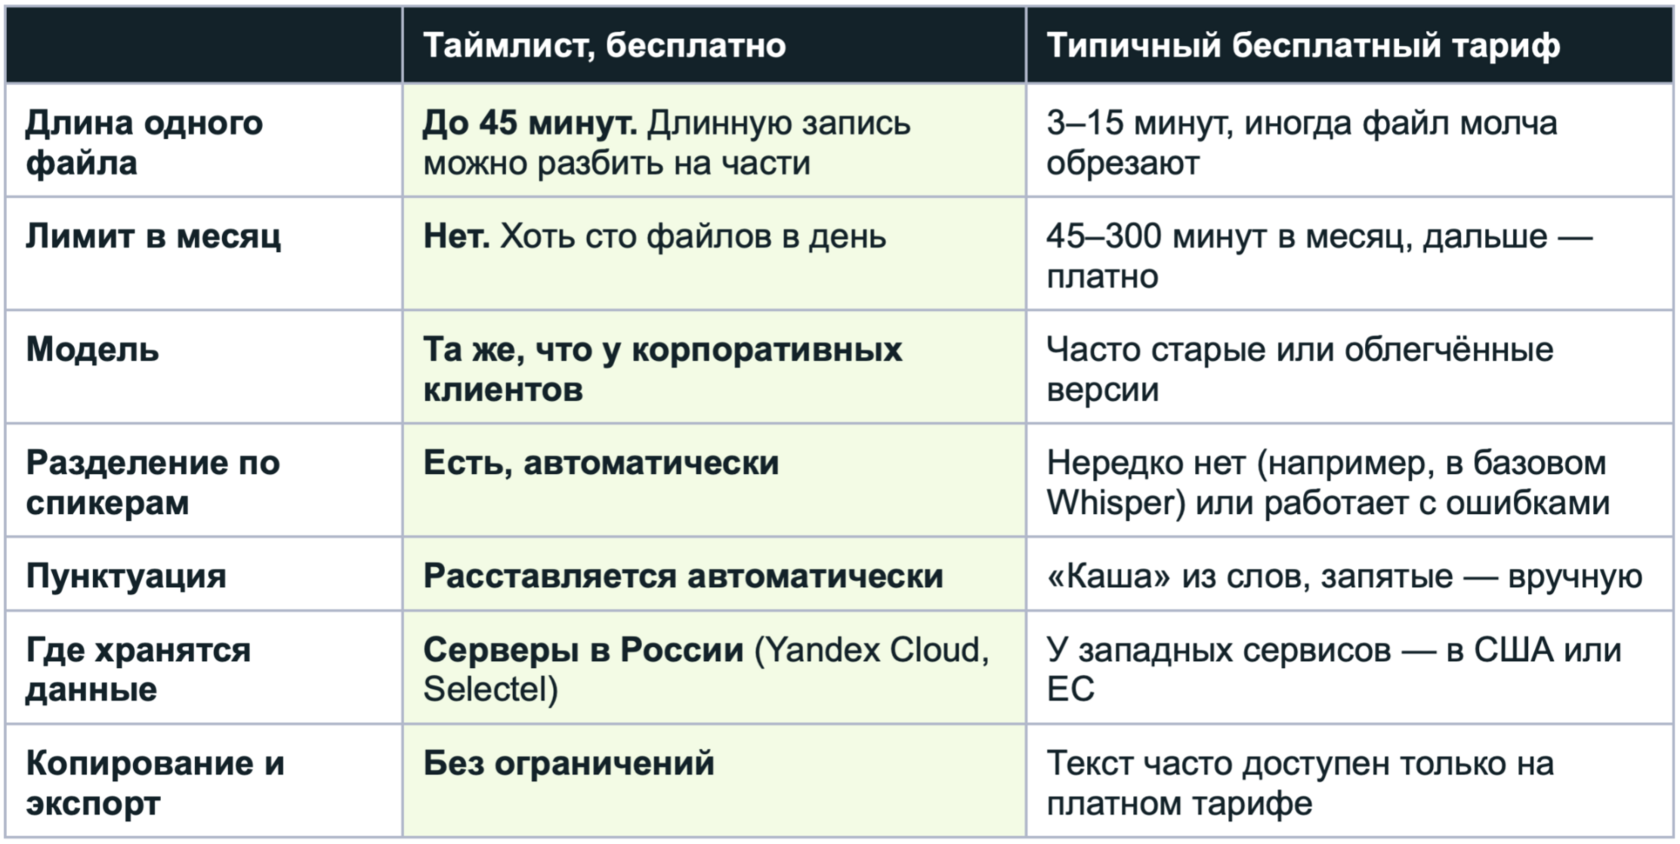
| Параметр | Таймлист, бесплатно | Типичный бесплатный тариф |
|---|---|---|
| Длина одного файла | До 45 минут. Длинную запись можно разбить на части | 3–15 минут, иногда файл молча обрезают |
| Лимит в месяц | Нет. Хоть сто файлов в день | 45–300 минут в месяц, дальше — платно |
| Модель | Та же, что у корпоративных клиентов | Часто старые или облегчённые версии |
| Разделение по спикерам | Есть, автоматически | Нередко нет (например, в базовом Whisper) или работает с ошибками |
| Пунктуация | Расставляется автоматически | «Каша» из слов, запятые — вручную |
| Где хранятся данные | Серверы в России (Yandex Cloud, Selectel) | У западных сервисов — в США или ЕС |
| Копирование и экспорт | Без ограничений | Текст часто доступен только на платном тарифе |
Почему мы не экономим на модели для бесплатных пользователей? Ошибка в расшифровке стоит денег. В медицине неверно распознанная дозировка опасна для пациента, в юриспруденции потерянная фраза может решить исход дела.
И отдельно про русский язык. Whisper от OpenAI — сильная модель, но учился он в основном на английском и спотыкается на нашей терминологии, окончаниях и междометиях. Наша модель заточена под русские совещания, и это видно в каждом абзаце расшифровки.
Как нейросеть переводит аудио в текст
Пока вы наливаете кофе, запись проходит шесть этапов.
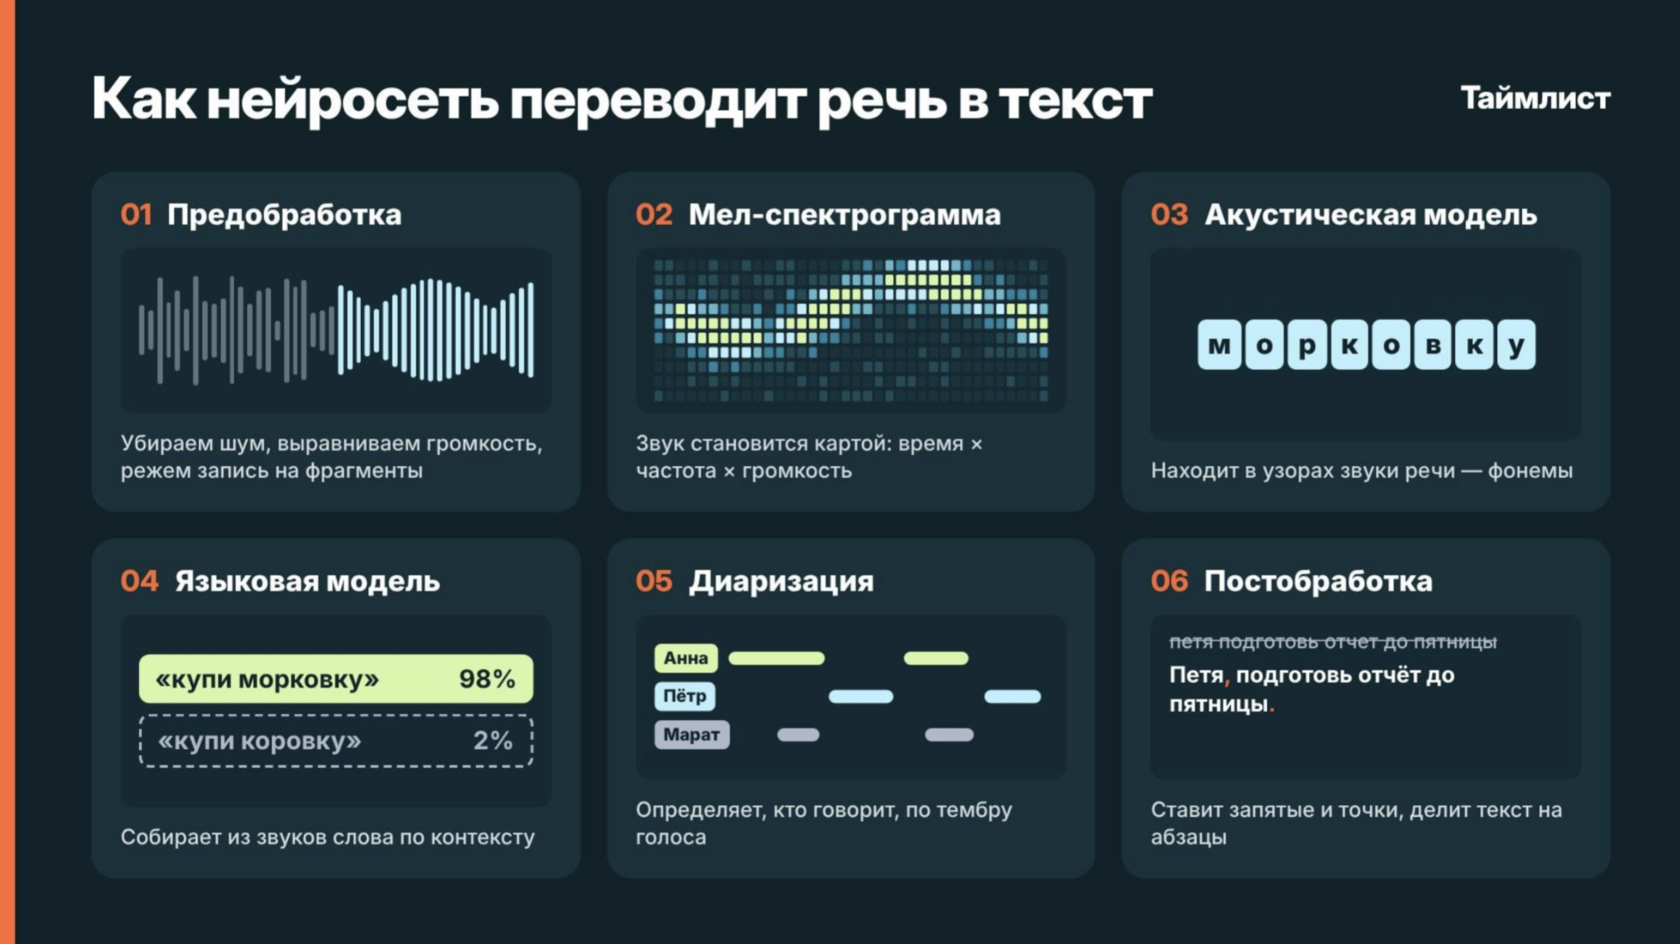
- Предобработка. Система убирает шум, выравнивает громкость и режет запись на короткие фрагменты — нейросети удобнее работать порциями.
- Мел-спектрограмма. Нейросеть не «слышит» звуковую волну — она смотрит на картинку. Аудио превращают в карту, где по горизонтали время, по вертикали частоты, а яркость показывает громкость. Эхо и плохой микрофон оставляют на этой карте «грязь» — поэтому качество записи так много решает.
- Акустическая модель находит в узорах спектрограммы звуки речи — фонемы. Современные архитектуры вроде Conformer сочетают свёрточные сети, которые выделяют устойчивые черты голоса и сглаживают акцент, и механизм внимания, который учитывает соседние звуки и слова.
- Языковая модель собирает из звуков осмысленные слова. Если звучит похоже и на «морковку», и на «коровку», она посмотрит на соседние слова и выберет подходящее. Сегодня обе модели часто объединяют в одну сквозную — так точнее и быстрее.
- Диаризация разделяет текст по говорящим — подробнее ниже.
- Постобработка расставляет знаки препинания, делит текст на абзацы и исправляет очевидные ошибки. В Таймлисте этот этап работает и в бесплатной версии.
Диаризация: кто что сказал
Распознавание речи отвечает на вопрос «что сказано», диаризация — «кто сказал». Система сравнивает тембр и тон голосов и группирует фрагменты по говорящим. Без неё расшифровка совещания выглядит как один длинный монолог, с ней — как протокол, где каждое решение привязано к человеку.
Слабые места диаризации — похожие голоса, гулкое помещение и моменты, когда люди говорят одновременно.
Где расшифровка аудио окупается
Технологии ради технологий — это сжигание бюджета. Транскрибация окупается там, где закрывает конкретную задачу.
Совещания
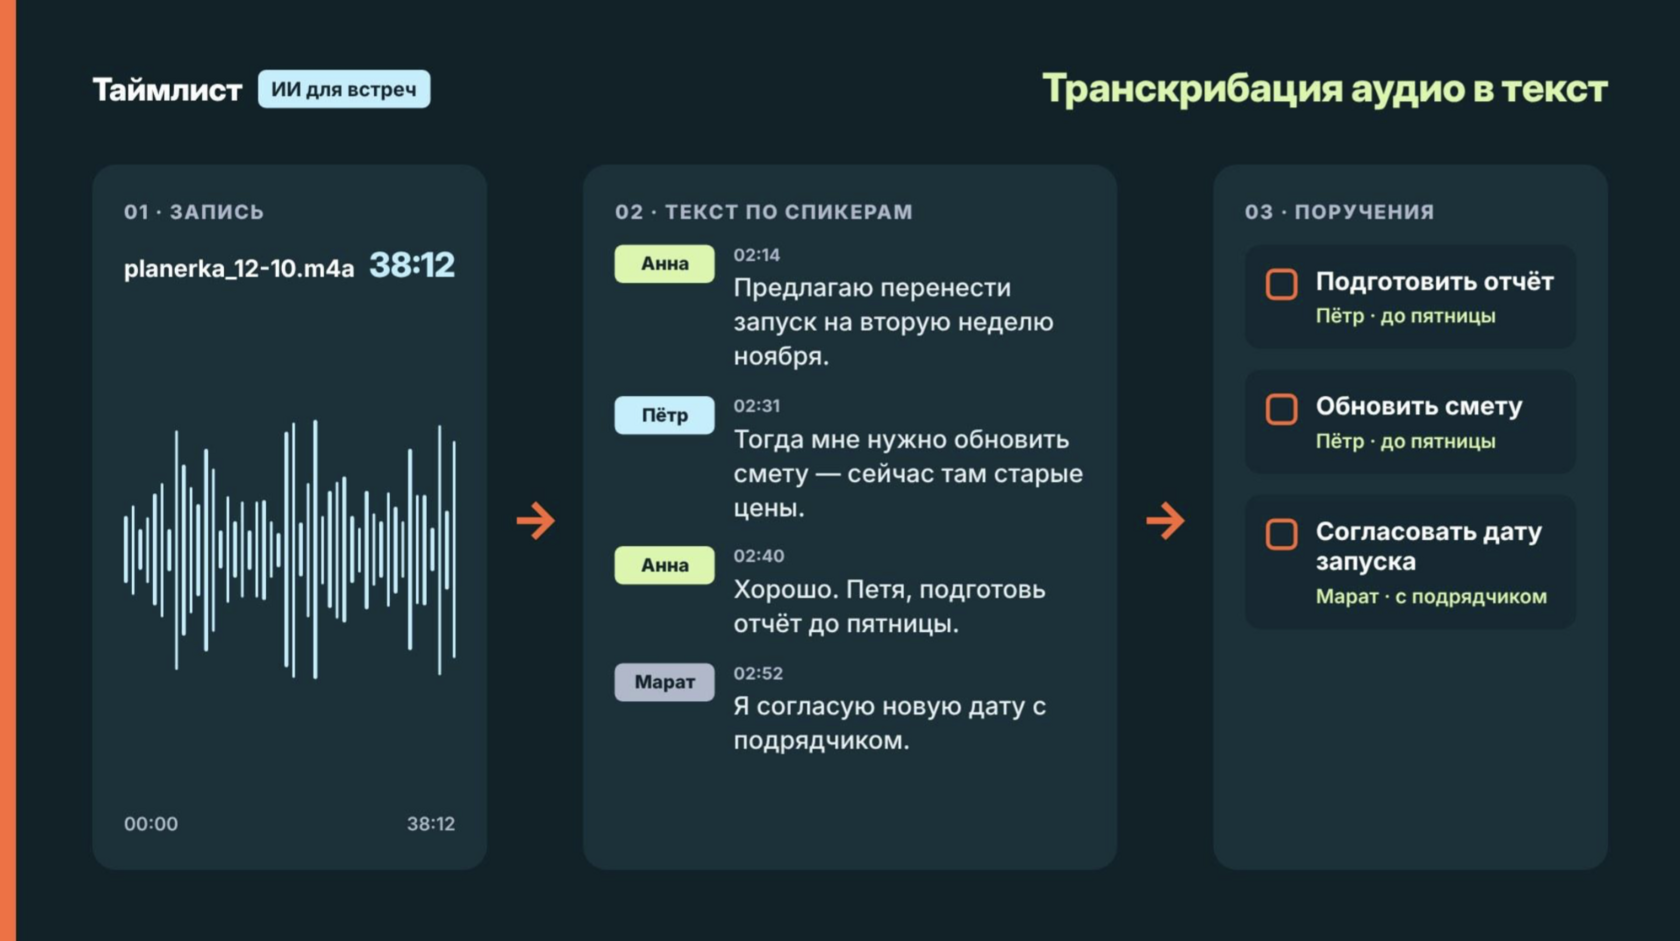
Наша основная ниша. Проблема встреч не в длине, а в амнезии после них: вы забыли, о чём договорились, пока шли до своего стола. Таймлист не только переводит аудио в текст, но и вытаскивает поручения: находит фразы вроде «Петя, подготовь отчёт до пятницы» и собирает список задач со сроками. Протокол можно выгрузить в 1С:Документооборот. Так контролируют исполнение решений, например, в РЖД и «Россети Новосибирск».
HR и подбор
Пять кандидатов по часу — пять часов записи. Когда текст разбит по спикерам, за пару минут видно, как каждый ответил на вопрос о стрессоустойчивости, — без перемотки.
PR, маркетинг и журналистика
Из часового интервью с экспертом нужно достать три сильные цитаты. Вместо пяти прослушиваний — Ctrl+F по тексту. Маркетологи так же разбирают звонки колл-центра и находят реальные потребности клиентов, а не придуманные.
Образование и наука
Конспекты лекций, расшифровки конференций и полевых интервью. По тексту можно искать: аудиоархив мёртв, текстовый — работает.
Юриспруденция
Здесь цена ошибки максимальна, а диаризация критична: нужно точно знать, где говорит судья, где адвокат, а где свидетель.
Сколько стоит расшифровка аудио
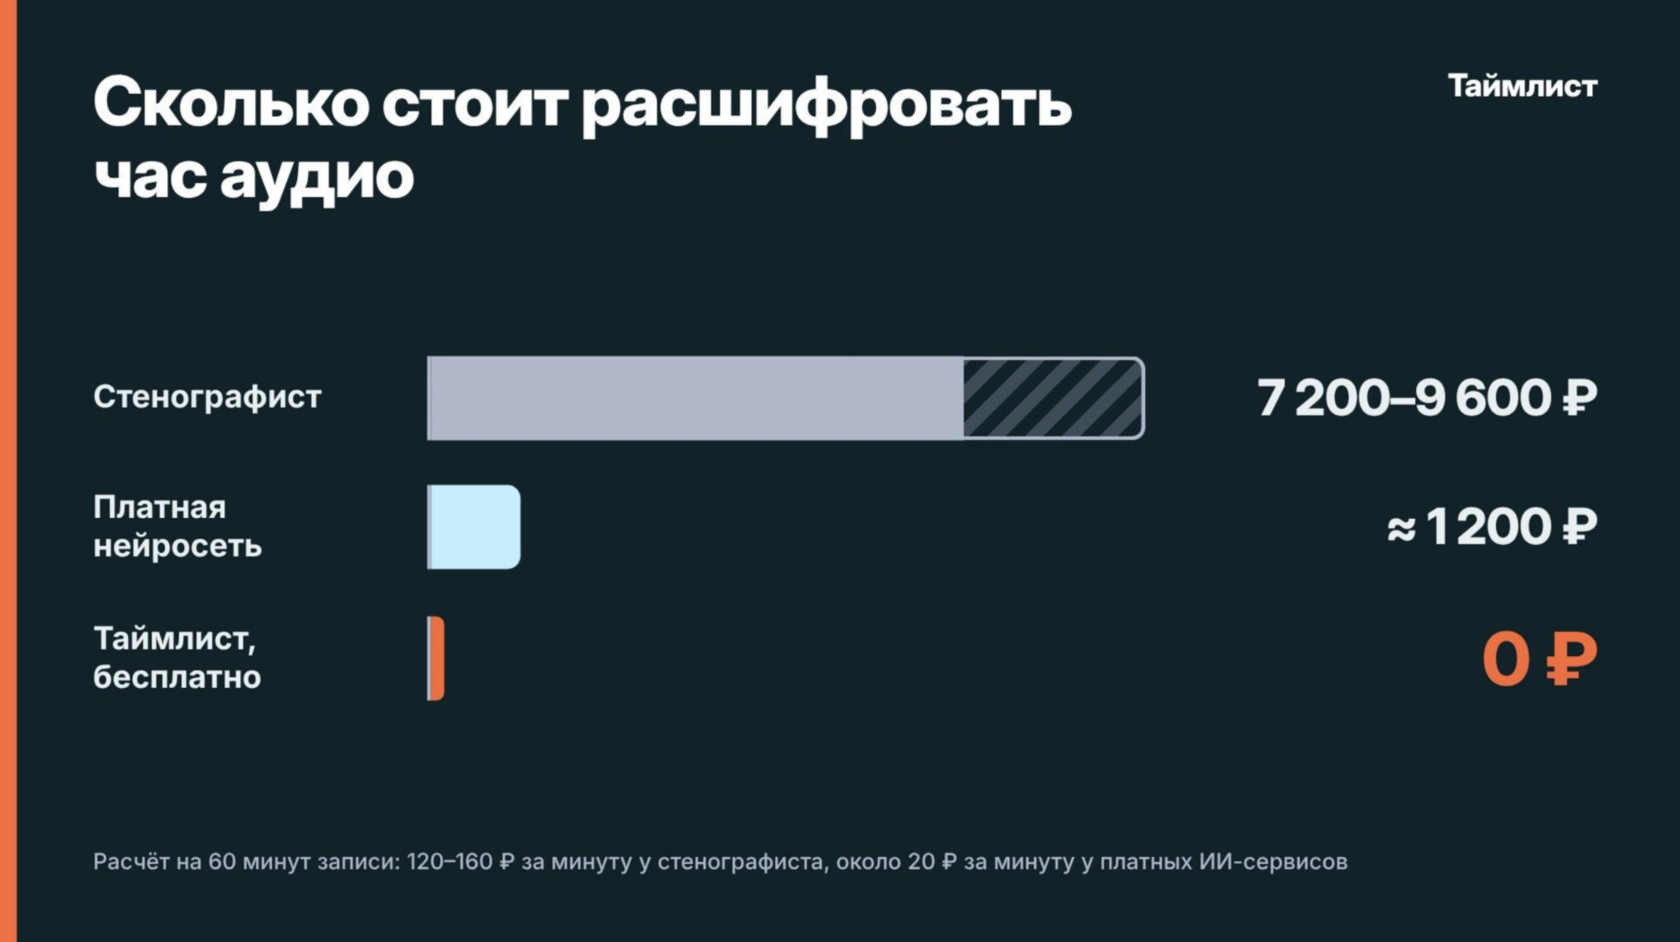
Стенографист берёт в среднем 120–160 ₽ за минуту — 7–10 тыс. ₽ за час записи. Платная расшифровка нейросетью — около 20 ₽ за минуту, в 6–8 раз дешевле. Бесплатная версия Таймлиста — 0 ₽, а сотрудник тратит освободившиеся часы на работу, а не на переписывание.
Почему лимит — 45 минут на файл
«Почему 45 минут? У других по три часа!» — первый вопрос, который мне задают. Модель справится и с более длинным файлом: это не техническое ограничение, а осознанный расчёт.
Посмотрите, как меняется внимание участников встречи. В первые 15 минут активно слушают 91% людей, во вторые — 84%, в третьи — 73%. После 45 минут — 64%: больше трети участников уже отключились. Они кивают в камеру, а сами отвечают на письма и планируют обед.
Лимит работает как мягкая рамка для организатора. Когда знаешь, что запись закончится на 45-й минуте, готовишься иначе: пишешь повестку, не льёшь воду, формулируешь вопросы заранее. Плотный разговор и нейросеть распознаёт точнее — перебивания и отступления двухчасовых «посиделок» бьют по качеству расшифровки.
Если встреча действительно длинная, разбейте запись на части. Трёхчасовая стратегическая сессия превратится в три сфокусированных протокола, у каждого — свои решения и задачи. Искать в них нужное проще, чем в простыне на 40 страниц.
Безопасность данных и галлюцинации ИИ
Отдавая запись в облако, важно понимать, кому вы её отдаёте. Многие западные сервисы обрабатывают аудио на серверах в США или Европе. Для компании, которая обсуждает финансы, персональные данные или коммерческую тайну, это риск нарушить 152-ФЗ «О персональных данных» и внутренние политики безопасности.
В Таймлисте аудио, видео и расшифровки хранятся на серверах в России — в инфраструктуре Yandex Cloud и Selectel с сертификатами ФСТЭК. Передача данных шифруется по HTTPS, доступ — через OAuth 2.0. Корпоративным клиентам разворачиваем решение в закрытом контуре, чтобы данные не выходили за периметр сети, и подписываем NDA.
Почему нейросеть иногда «додумывает» текст
Модели распознавания речи иногда пишут слова, которых в записи не было, — чаще всего на паузах, кашле или фоновом шуме. В обучающих данных за тишиной обычно следовала фраза, и модель пытается её «угадать». Исследователи находили в расшифровках Whisper целые выдуманные предложения — вплоть до несуществующих названий лекарств.
Наша модель обучена на русской деловой речи и ошибается так гораздо реже. Но скажу прямо: критичные цифры, имена и фамилии всегда проверяйте. ИИ — усилитель вашего мышления, а не замена ему.
От «Одри» до Whisper: как развивалось распознавание речи
Путь от шкафа, который различал десять цифр, до систем, которые разделяют голоса и расставляют запятые, занял 70 лет.
- 1952Bell Labs собирает «Одри» (Audrey): релейный шкаф почти двухметровой высоты распознаёт цифры от 0 до 9, но только голосом своего создателя.
- 1962IBM Shoebox понимает 16 слов — цифры и команды вроде «плюс» и «итого» — и передаёт задачу калькулятору.
- 1970-еПоявляются статистические методы, включая скрытые марковские модели, и системы начинают понимать слитную речь. Harpy из Университета Карнеги — Меллона (1976) знает около тысячи слов.
- 1980-еIBM Tangora работает со словарём в 20 000 слов, но всё ещё требует обучения под голос пользователя.
- 1997Dragon NaturallySpeaking — первая массовая программа диктовки, в которой не нужно делать паузы между словами.
- 2014Baidu Deep Speech: одна большая нейросеть вместо конвейера из десятка моделей и ручных правил.
- 2016–2017Microsoft догоняет профессиональных стенографистов по точности на записях телефонных разговоров.
- 2022OpenAI выпускает Whisper, обученный на сотнях тысяч часов записей из интернета: он распознаёт десятки языков и умеет переводить.
Что дальше
Главный вектор — понимание контекста. Сейчас модель может потерять нить длинного разговора: на пятой минуте прозвучало «Иван Иванович», на сороковой — «он», и связь теряется. Следующий шаг — давать системе справку заранее: перед медицинским консилиумом — анамнез, перед совещанием — повестку и глоссарий. Это заметно снижает ошибки в специальных терминах.
Вторая задача — речь внахлёст. Когда двое говорят одновременно, диаризация пока ломается. Решив её, можно будет получать точные протоколы даже с самых шумных мозговых штурмов.
Мы постоянно дообучаем модели на новых корпоративных данных и видим, как распознавание речи превращается из «перевода звука в буквы» в аналитический инструмент, который вытаскивает из разговора решения и задачи.
Частые вопросы
Можно ли перевести аудио в текст бесплатно и без ограничений?
Да. В Таймлисте нет месячного лимита минут: загружайте хоть сто файлов в день. Один файл — до 45 минут, длинную запись разбейте на части.
Бесплатная версия распознаёт хуже платной?
Нет. Бесплатная транскрибация работает на той же модели, что и у корпоративных клиентов.
Текст разделяется по спикерам?
Да. Диаризация и расстановка знаков препинания работают автоматически.
Насколько точная расшифровка?
96–97% на чистой записи по нашим внутренним замерам. На шумных записях и при одновременной речи точность ниже, поэтому имена и цифры стоит проверять.
Где хранятся мои записи?
На серверах в России — в Yandex Cloud и Selectel. Для компаний возможна установка в закрытом контуре.
Можно ли скопировать и выгрузить текст?
Да, без ограничений и доплат.
Сравните сами на своей записи
Если вы до сих пор расшифровываете встречи вручную или пользуетесь сервисом, который режет минуты и качество, загрузите запись своего следующего созвона в Таймлист и сравните.
Бесплатная транскрибация может быть качественной, а лимит в 45 минут заодно научит проводить встречи короче.
Попробовать бесплатно